AI
RAG-система: поиск по документам и базе знаний без лишней магии
Что нужно подготовить, чтобы AI отвечал по проверенным источникам, показывал ссылки и учитывал права доступа.
Какую задачу решает RAG
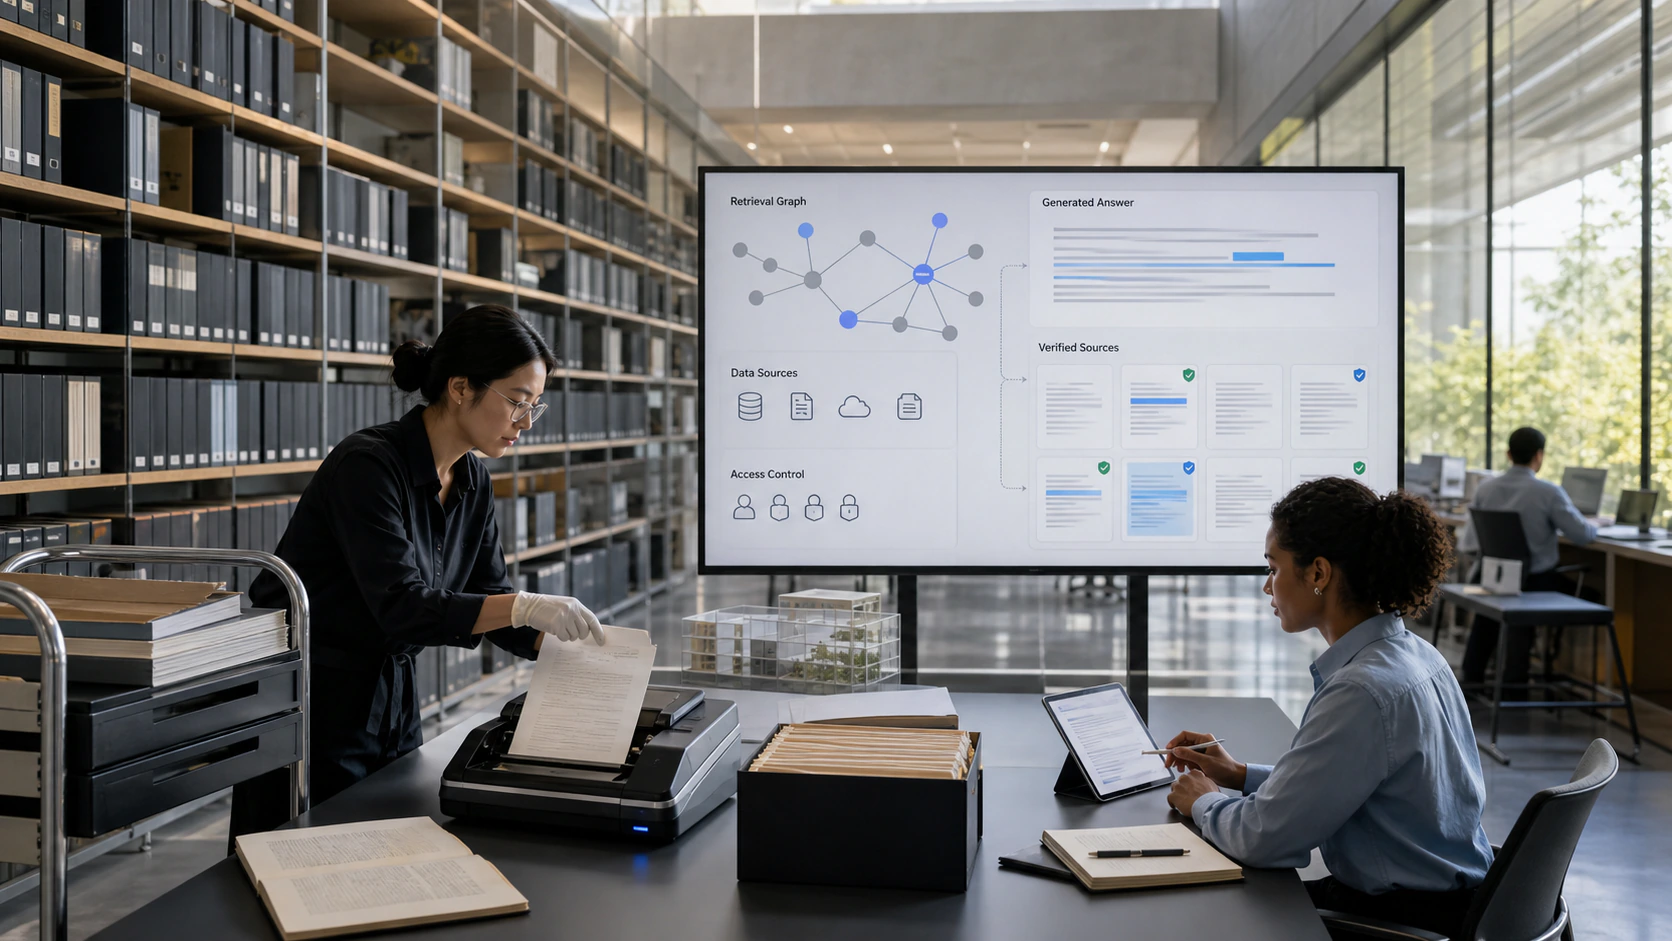
RAG используют, когда обычного ответа модели недостаточно. Бизнесу часто нужно, чтобы AI отвечал по внутренним регламентам, договорам, базе знаний, справочным материалам или продуктовой документации. В такой задаче важна не только формулировка ответа, но и проверяемость: пользователь должен понимать, на какие источники опиралась система.
Без RAG модель может уверенно сформулировать ответ, который звучит правдоподобно, но не соответствует документам компании. RAG добавляет слой поиска: сначала система находит релевантные фрагменты, затем передаёт их в модель как контекст и только после этого формирует ответ. Это не делает систему безошибочной, но создаёт основу для контроля.
Подготовка источников
Качество RAG начинается до подключения модели. Документы нужно привести к понятной структуре: удалить дубли, отделить устаревшие версии, задать владельцев, определить частоту обновления и описать права доступа. Если источники противоречат друг другу, система будет наследовать этот конфликт.
- Разделить источники по типам: регламенты, инструкции, коммерческие условия, справка, FAQ, переписка.
- Зафиксировать статус документа: актуальный, архивный, черновик или внутренний.
- Добавить метаданные: владелец, дата обновления, отдел, уровень доступа.
- Подготовить правила разбиения документов на фрагменты.
- Проверить, что ссылки на источники можно показать пользователю.
Поиск, доступ и контекст
Хороший поиск по знаниям учитывает не только текст запроса. Он должен понимать роль пользователя, доступные ему документы, язык запроса, продуктовую область и историю взаимодействия. Внутри компании один и тот же вопрос может иметь разные допустимые ответы для сотрудника поддержки, менеджера продаж и внешнего клиента.
Поэтому в архитектуре появляются два уровня ограничений. Первый определяет, какие документы вообще участвуют в поиске. Второй проверяет, можно ли показать найденный фрагмент конкретному пользователю. Такое разделение помогает не раскрывать лишние данные и делает ответы предсказуемее.
- Роль пользователя и его права доступа.
- Тип вопроса и ожидаемый формат ответа.
- Набор документов, разрешённых для поиска.
- Ссылки на фрагменты, которые можно показать в интерфейсе.
- Правила отказа, если источники не дают уверенного ответа.
Контроль качества после запуска
После запуска RAG-систему нельзя считать завершённой. Её нужно измерять: какие вопросы задают пользователи, где система не нашла источник, какие ответы получили низкую оценку, сколько стоит обработка запроса и какие документы чаще всего используются.
Полезно собирать тестовый набор вопросов и регулярно прогонять его при изменении базы знаний, модели или правил поиска. Так команда видит, что обновление улучшило сценарий, а не сломало важные ответы.
Как спроектировать RAG-систему для реальных документов
RAG-система для базы знаний должна находить не просто похожий текст, а действующий и разрешенный пользователю источник. Для этого поисковый слой учитывает метаданные, версии, роль, язык и тип вопроса, а интерфейс показывает ссылку и умеет честно сообщить, что надежного ответа нет.
Качество удобно разделять на этапы: документы, извлечение, поиск, формирование ответа и пользовательский результат. Тогда команда понимает, улучшать ли разбиение, фильтр, ранжирование, инструкцию модели или саму базу знаний, вместо бесконечной смены модели.
Типичные ошибки
Ошибки чаще возникают на границах ответственности и в неявных предположениях. Их полезно разобрать заранее и включить в приемочные сценарии.
- Оценивать только правдоподобие ответа без правильности найденного документа.
- Разрезать исключение отдельно от правила и передавать модели неполный контекст.
- Фильтровать права после поиска или уже после генерации ответа.
- Оставлять старую редакцию в индексе после удаления из хранилища.
- Не тестировать конфликтующие источники, неоднозначный запрос и отсутствие данных.
Что определить до начала работ
До выбора инструментов команда фиксирует исходный процесс, ограничения и критерии результата. Это уменьшает число решений, которые иначе пришлось бы принимать уже внутри разработки.
- Реестр источников с владельцами, версиями, статусом и уровнем доступа.
- Набор вопросов с правильными фрагментами, ответами и допустимыми отказами.
- Типы документов, таблиц, изображений и особенности извлечения структуры.
- Требования к ссылкам, цитированию, языкам и времени обновления индекса.
- Ограничения по данным, размещению модели, логам и сроку хранения запросов.
Как устроить рабочий контур
Устойчивый результат складывается из продукта, данных, технологий и эксплуатации. Если один из слоев не имеет владельца, система начинает зависеть от ручного контроля.
- Источник документов и конвейер версий, извлечения, очистки и индексации.
- Точный и векторный поиск, фильтры, reranker и ограничение контекста.
- Модель с инструкцией использовать источники и структурировать ответ.
- Сервис прав, ссылки на исходные фрагменты и журнал выдачи.
- Набор оценки и аналитика вопросов без ответа, стоимости и задержки.
Пошаговый план работы
Последовательность идет от проверки задачи к ограниченному запуску и измерению. Каждый этап должен уменьшать конкретную неопределенность и завершаться понятным решением.
- Очистить дубли и отделить действующие документы от архива и черновиков.
- Настроить извлечение и смысловое разбиение с сохранением иерархии и источника.
- Добавить метаданные и фильтрацию доступа до смыслового поиска.
- Сравнить гибридный поиск и ранжирование на эталонных вопросах.
- Сформировать ответ только по найденному контексту, показать источники и правило отказа.
- Запустить мониторинг, разметку ошибок и регулярный регрессионный тест.
Как измерить результат
Метрики выбирают до запуска и сравнивают с исходным процессом. Количество выпущенных функций не показывает, стала ли работа пользователя быстрее, надежнее или понятнее.
- Recall и точность релевантного источника на контрольном наборе.
- Фактическая корректность, полнота ссылок и успешность правильного отказа.
- Нарушения доступа и доля ответов по устаревшей версии.
- Задержка, стоимость и объем контекста на один полезный ответ.
- Пользовательская оценка, повтор вопроса и передача специалисту.
Практический вывод
RAG — это поисковый продукт с генеративным интерфейсом. Его надежность зависит от управления знаниями и измерения каждого этапа, а не только от способности модели красиво сформулировать ответ.
После запуска тестовый набор пополняют реальными сложными вопросами. Так система развивается вместе с документами и не теряет качество при смене модели, индекса или правил доступа.
Источники
Материал подготовлен редакцией на основе проектной практики и не содержит внешних статистических утверждений.
FAQ
Сколько документов нужно для запуска RAG?
Важнее не количество, а покрытие одного сценария и качество источников. Пилот можно начать с небольшого утвержденного набора и расширять по вопросам без ответа.
Нужна ли векторная база?
Она полезна для смыслового поиска, но не всегда обязательна. Часто лучший результат дает комбинация точного, полнотекстового и векторного поиска с фильтрами.
Как учитывать права доступа?
Фильтровать доступный набор до передачи документов поиску и модели, используя роль и политику исходной системы.