SEO и аналитика
Как оценивать качество AI-сценария после запуска
Какие сигналы помогают понять, что AI-сценарий действительно помогает пользователям и не создаёт лишний риск.
Какие сигналы отслеживать
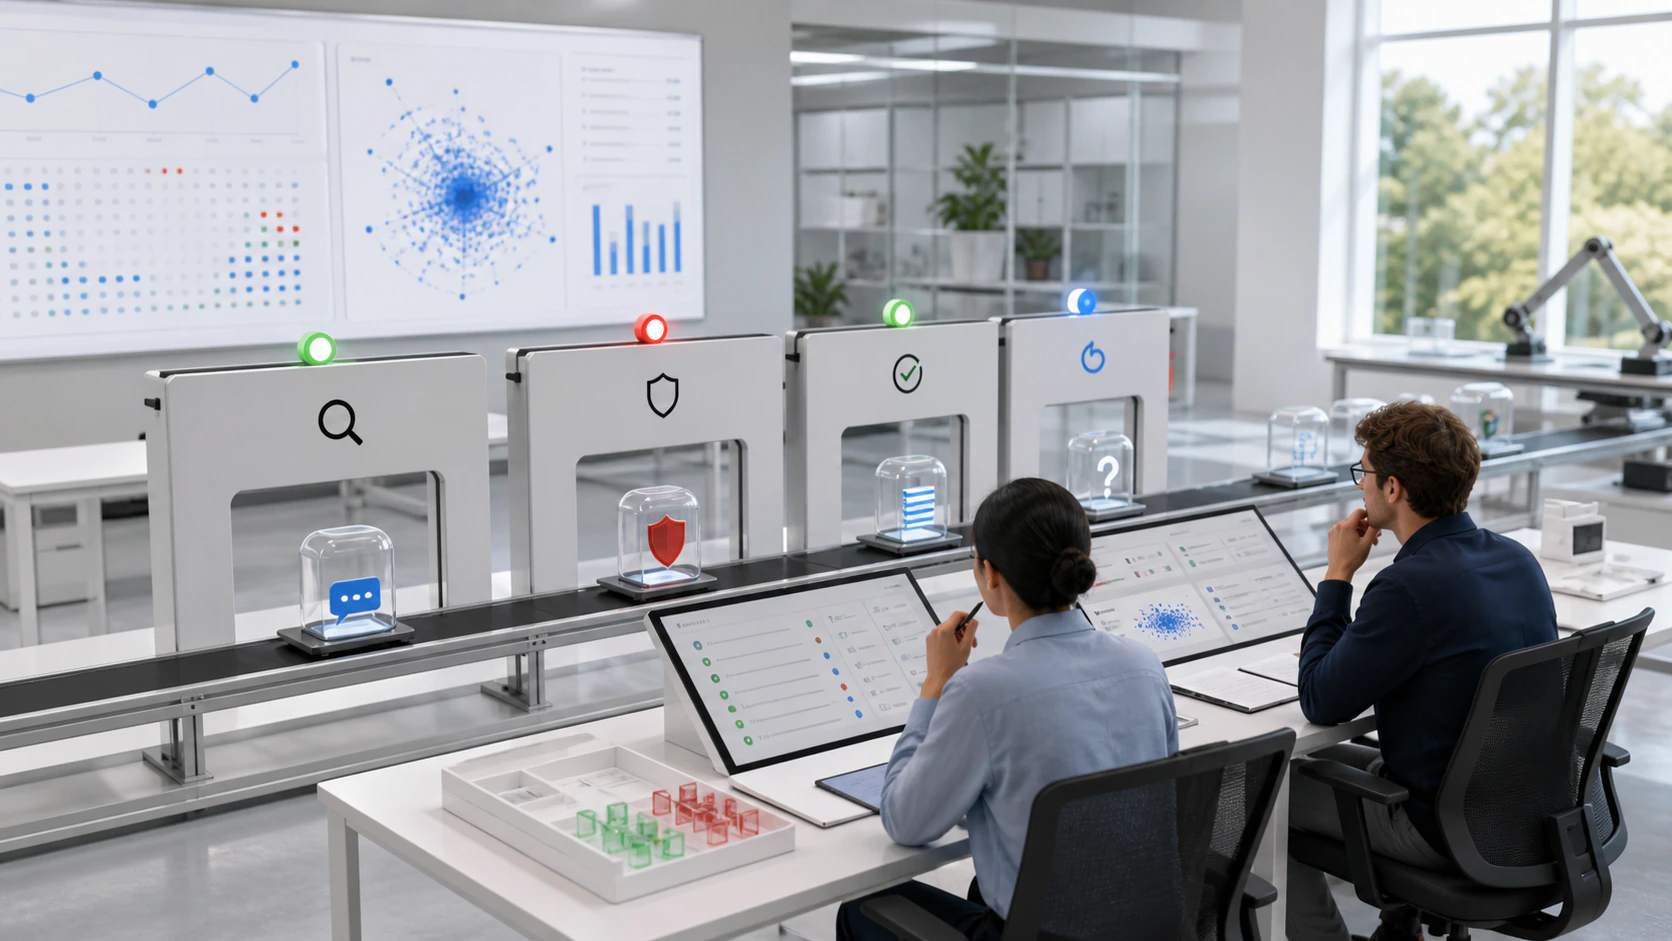
После запуска важно смотреть не только на количество запросов. Сценарий может быть популярным, но давать слабые ответы или требовать постоянной ручной проверки. Поэтому метрики должны описывать пользу, качество и стоимость.
- Оценка ответа пользователем.
- Доля эскалаций к человеку.
- Ошибки поиска источников.
- Стоимость обработки запроса.
- Повторные вопросы по одной теме.
- Время до полезного результата.
Цикл пересмотра
AI-сценарий нужно регулярно пересматривать: обновлять источники, уточнять правила, расширять тестовый набор вопросов и отключать действия, которые создают риск или не дают пользы.
Что означает качество AI-сценария
Качество AI-сценария определяется не красотой отдельного ответа, а успешностью пользовательской задачи в допустимых границах риска, времени и стоимости. Для поиска по документам важны источник и отказ, для классификации — правильный класс, для агента — фактически выполненное действие.
Оценка должна быть воспроизводимой. Команда собирает набор реальных примеров, критерии и эталон, затем прогоняет его при изменении модели, промпта, поиска или данных. Пользовательская обратная связь дополняет набор новыми случаями, но не заменяет системную приемку.
Как устроить рабочий контур
Устойчивый результат складывается из продукта, данных, технологий и эксплуатации. Если один из слоев не имеет владельца, система начинает зависеть от ручного контроля.
- Версионированный датасет с источником примера и ответственным экспертом.
- Рубрики фактичности, полноты, формата, безопасности и полезности.
- Автоматический прогон моделей, промптов и конфигураций с сохранением трассировки.
- Ручное ревью спорных случаев и согласование расхождений оценщиков.
- Production-метрики, обратная связь, стоимость и процедура отката версии.
Что определить до начала работ
До выбора инструментов команда фиксирует исходный процесс, ограничения и критерии результата. Это уменьшает число решений, которые иначе пришлось бы принимать уже внутри разработки.
- Определение успешного результата и недопустимой ошибки для каждого типа запроса.
- Реальные примеры по частым, сложным, пограничным и запрещенным сценариям.
- Эталонный ответ, источник, класс или действие и допустимые варианты формулировки.
- Сегменты пользователей, языки, права и контекст, меняющие правильный результат.
- Базовая версия системы, с которой сравнивается каждое изменение.
Пошаговый план работы
Последовательность идет от проверки задачи к ограниченному запуску и измерению. Каждый этап должен уменьшать конкретную неопределенность и завершаться понятным решением.
- Разделить качество поиска, генерации, инструментов и итогового пользовательского результата.
- Создать рубрику оценки с ясными шкалами и примерами для экспертов.
- Автоматизировать стабильные проверки и оставить человеку предметную неоднозначность.
- Провести слепое сравнение вариантов на одном наборе и одинаковых параметрах.
- Добавить стресс-тесты на отказ, инъекцию, отсутствие данных и недоступность системы.
- Запустить мониторинг production и превращать подтвержденные ошибки в регрессионные тесты.
Как измерить результат
Метрики выбирают до запуска и сравнивают с исходным процессом. Количество выпущенных функций не показывает, стала ли работа пользователя быстрее, надежнее или понятнее.
- Успешность задачи и отдельная доля критических ошибок.
- Корректность источника, фактов, формата и правила отказа.
- Согласованность оценщиков и стабильность на переформулированных запросах.
- Задержка и стоимость одного принятого результата.
- Регрессии после изменения данных, модели, промпта или инструмента.
Типичные ошибки
Ошибки чаще возникают на границах ответственности и в неявных предположениях. Их полезно разобрать заранее и включить в приемочные сценарии.
- Оценивать на нескольких заранее удачных примерах из презентации.
- Смешивать ошибку поиска документа и ошибку формулировки модели.
- Использовать только другую модель как судью без предметной проверки.
- Менять одновременно модель, промпт и индекс и не понимать причину результата.
- Оптимизировать среднюю оценку, игнорируя редкую критическую ошибку.
Практический вывод
Оценка AI — это непрерывная продуктовая функция, а не финальный тест перед релизом. Данные, пользователи и модели меняются, поэтому контрольный набор и пороги должны иметь владельца.
Зрелая команда умеет объяснить, какую ошибку исправило изменение и какую цену оно добавило. Это позволяет улучшать систему по доказательствам, а не по впечатлению от новой модели.
Источники
Материал подготовлен редакцией на основе проектной практики и не содержит внешних статистических утверждений.
FAQ
Сколько примеров нужно для оценки?
Зависит от разнообразия сценария. Начните с покрытия основных классов и рисков, затем расширяйте набор реальными подтвержденными ошибками.
Можно ли полностью автоматизировать оценку?
Формат и детерминированные правила — да. Предметную корректность и неоднозначность часто должен периодически проверять эксперт.
Что тестировать после смены модели?
Тот же регрессионный набор, критические сценарии, стоимость, задержку, отказ и безопасность. Улучшение средней оценки не должно скрывать новую критическую ошибку.