AI
Безопасность AI-агентов: доступы, действия и контроль
Как проектировать безопасность AI-агентов: минимальные права, подтверждение действий, защита данных, журналирование, тестирование и аварийная остановка.
Чем AI-агент отличается по рискам от чат-бота
Безопасность AI-агентов становится критичной, когда система не только формирует текст, но и вызывает инструменты: читает CRM, отправляет письмо, создает счет или меняет запись. Ошибочный ответ чат-бота можно заметить до действия, а неверный вызов API способен сразу повлиять на клиента, данные или деньги.
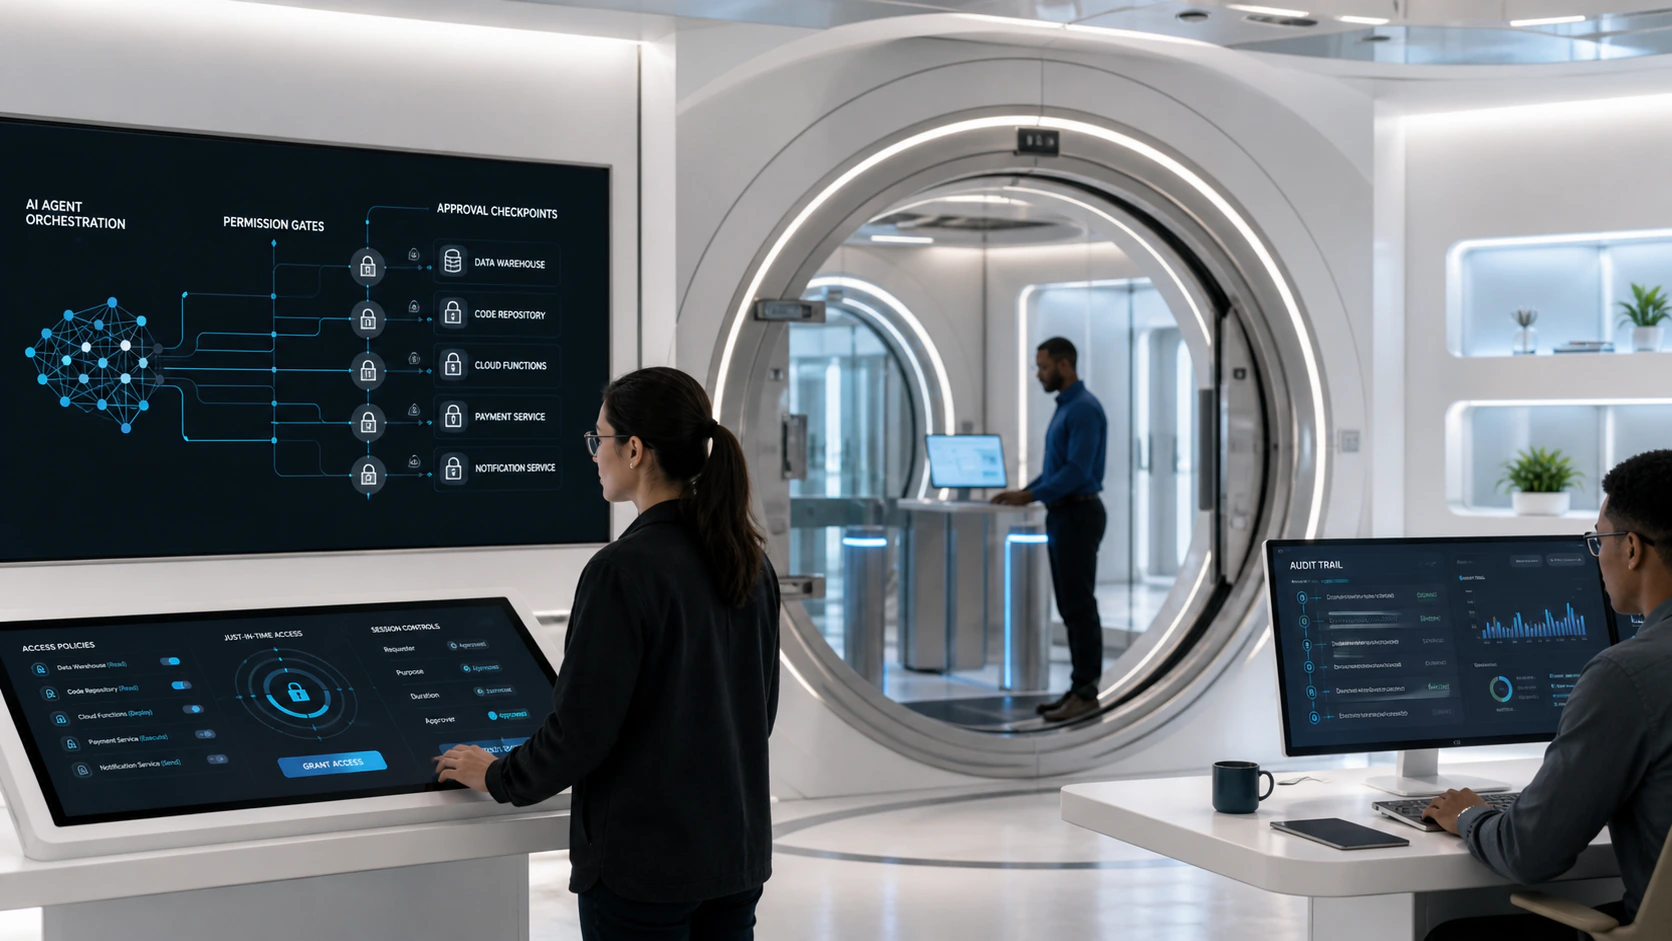
Защита строится несколькими независимыми слоями. Модель предлагает действие, но права, параметры, бизнес-правила и подтверждение проверяет обычный детерминированный код. Такое разделение уменьшает зависимость от непредсказуемой формулировки и оставляет понятный след для аудита.
Модель угроз и карта действий
До подключения инструментов нужно перечислить, что агент может увидеть, изменить и передать наружу.
- Каталог действий с уровнем риска: чтение, создание черновика, запись, удаление и финансовая операция.
- Роли пользователей и сервисные учетные записи с минимально необходимыми разрешениями.
- Типы конфиденциальных данных и правила их передачи модели, логам и внешним системам.
- Сценарии злоупотребления, prompt injection, ошибочного выбора инструмента и повторного вызова.
- Ответственные за остановку системы, расследование инцидента и восстановление изменений.
Как безопасно подключать инструменты
Каждое новое действие проходит путь от режима чтения к ограниченному пилоту и только затем к автоматическому выполнению.
- Выдать отдельную сервисную учетную запись и ограничить доступ конкретными объектами и операциями.
- Описать строгую схему параметров и проверять значения до вызова внешнего API.
- Добавить предварительный просмотр и подтверждение пользователя для необратимых или дорогих действий.
- Сделать операции идемпотентными, чтобы повторный запрос не создавал дубли.
- Записывать решение агента, выбранный инструмент, параметры, результат и идентификатор пользователя.
- Проверить аварийное отключение инструмента и восстановление на тестовом инциденте.
Обязательные защитные слои
Надежность появляется, когда ни одна проверка не зависит исключительно от ответа языковой модели.
- Шлюз инструментов с белым списком операций, схемами параметров и ограничением частоты.
- Политики доступа, которые выполняются после выбора действия и до обращения к данным.
- Изоляция недоверенного содержимого документов, писем и веб-страниц от системных инструкций.
- Подтверждение человеком, лимиты суммы, области изменений и числа затрагиваемых объектов.
- Наблюдаемость: трассировка, предупреждения, журнал аудита и возможность воспроизвести цепочку.
Опасные упрощения
Фраза в системном промпте не заменяет технического запрета и проверки полномочий.
- Использовать учетную запись администратора, потому что так проще подключить прототип.
- Передавать модели секреты или токены вместо обращения к инструменту через защищенный сервер.
- Разрешать отправку, удаление или оплату без предварительного показа результата пользователю.
- Смешивать системные инструкции и внешнее содержимое, которое может содержать вредоносные команды.
- Хранить подробные логи с персональными данными без срока удаления и разграничения доступа.
Как проверять безопасность после запуска
Контроль включает технические события, человеческие подтверждения и регулярные атаки на тестовом контуре.
- Доля действий, остановленных политикой, подтверждением или проверкой параметров.
- Количество избыточных прав у сервисных учетных записей и время их устранения.
- Успешность тестов на prompt injection, утечку данных и обход ограничений.
- Число повторных, конфликтующих или необратимых операций на тысячу запусков.
- Время обнаружения, отключения инструмента и восстановления после учебного инцидента.
Безопасность как условие автономности
Чем выше автономность агента, тем уже должны быть его права и строже проверка каждого действия. Полезная архитектура постепенно снимает ручные подтверждения только там, где накоплена статистика и цена ошибки остается приемлемой.
Безопасный AI-агент — это не одна модель, а система политик, интеграций, журналов и ответственных людей. Именно эти элементы позволяют развивать сценарий без неконтролируемого роста риска.
Источники
Материал подготовлен редакцией на основе проектной практики и не содержит внешних статистических утверждений.
FAQ
Можно ли полностью запретить prompt injection?
Нельзя полагаться на один фильтр. Риск снижают изоляция внешнего контента, минимальные права, проверка параметров и запрет опасных действий без подтверждения.
Какие действия всегда требуют подтверждения?
Это зависит от цены ошибки, но обычно подтверждают платежи, удаление, публикацию, массовую рассылку и изменение прав доступа.
Нужно ли хранить все рассуждения модели?
Для аудита важнее сохранять входные данные в допустимом объеме, выбранное действие, параметры, результат и пользователя, не накапливая лишние конфиденциальные данные.