Разработка
CI/CD: план внедрения проверяемых релизов
Как внедрить CI/CD по шагам: собрать конвейер сборки и тестов, защитить секреты, подготовить развертывание, откат и измерение стабильности релизов.
Что должен обеспечить конвейер выпуска
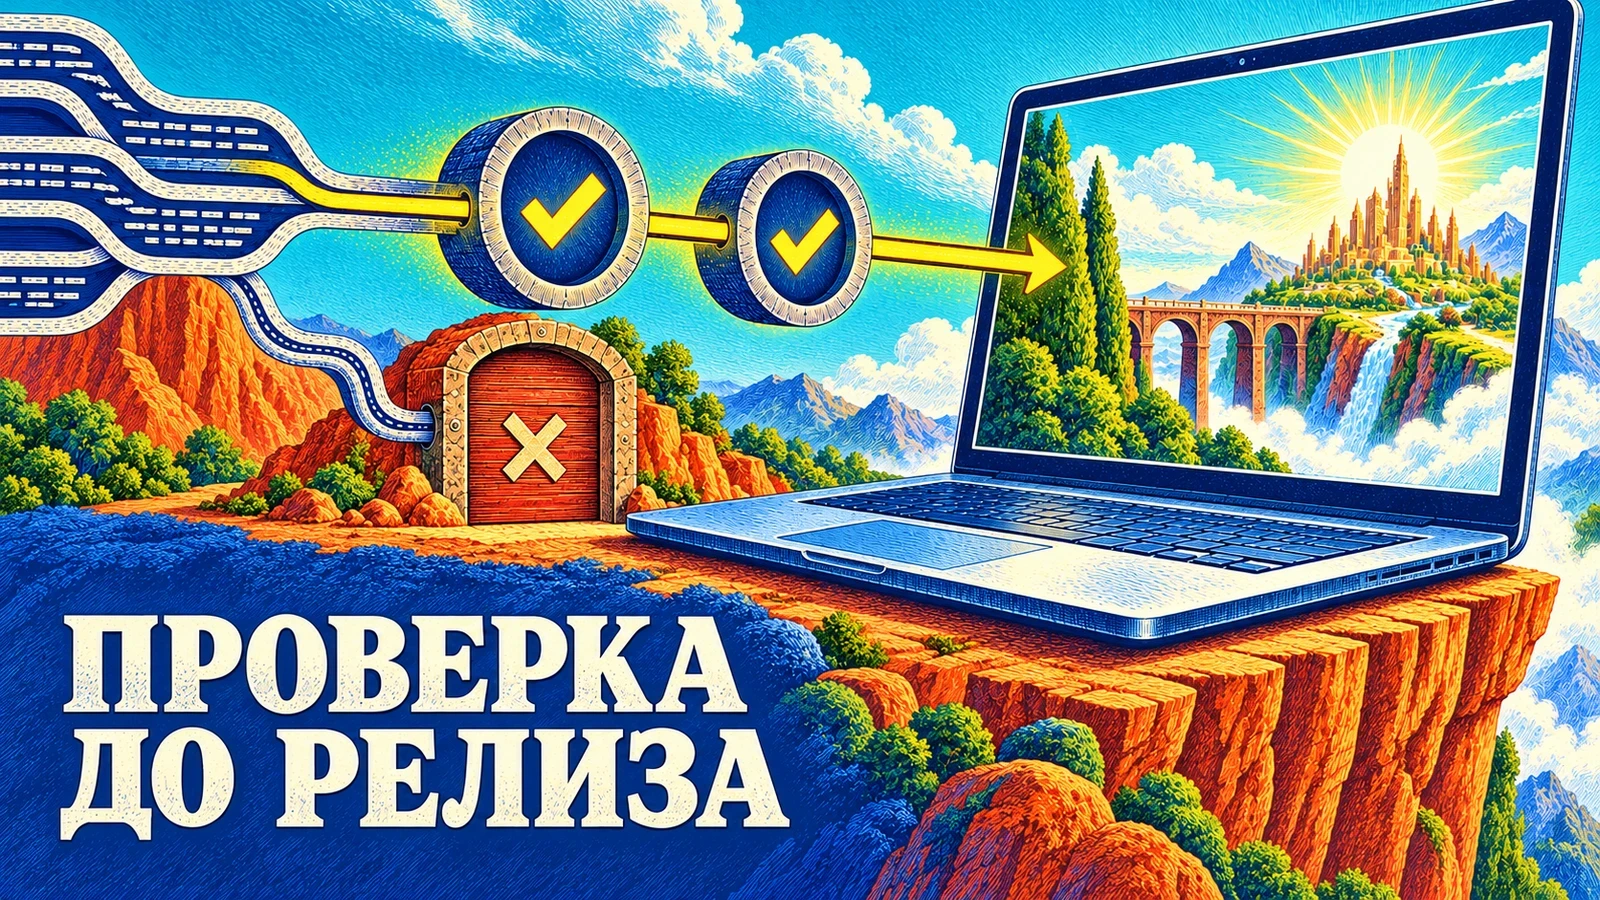
CI/CD полезен не фактом наличия файла конфигурации, а возможностью воспроизводимо собрать изменение, проверить его до развертывания и понять, что произошло после. Непрерывная интеграция объединяет частые небольшие изменения и запускает автоматические проверки. Доставка готовит проверенный результат к выпуску; автоматический деплой включают лишь там, где риски и механизм восстановления управляемы.
Начинайте с маршрута одного приложения: от изменения в репозитории до наблюдаемой версии в продакшене. Первая цель — убрать ручные неповторяемые действия и позднее обнаружение ошибок. Попытка автоматизировать все системы компании одновременно затягивает работу и скрывает слабое место основного сервиса.
Где автоматизация создаёт ложную уверенность
Зелёный pipeline говорит лишь о выполненных проверках — не о полноте их набора.
- Одни и те же нестабильные тесты регулярно перезапускают до зелёного статуса. Так команда перестаёт видеть настоящий сбой.
- Секреты живут в репозитории или передаются каждому job без ограничения. После компрометации отдельного шага затронуты все окружения.
- Релизный скрипт меняет активную сборку до проверки новой версии, а старый артефакт уже удалён; откат становится новой сборкой в аварийном режиме.
- База данных обновляется разрушительно до совместимого кода. Возвращение старой версии после такой миграции не восстанавливает сервис.
- Мониторинг смотрит только на HTTP 200 и пропускает сломанный заказ, авторизацию или фоновые операции.
Зафиксируйте исходный процесс выпуска
До выбора платформы опишите нынешний путь к продакшену и стоимость типичной ошибки.
- Составьте цепочку: ветка, проверка кода, сборка, тесты, артефакт, окружение, миграции, переключение трафика, мониторинг и ответственный за откат.
- Запишите версии языка, менеджера зависимостей, образа сборки и системных пакетов. Сборка из разной среды не является воспроизводимой.
- Отделите быстрые проверки pull request от долгих проверок после слияния. Падающий или постоянно пропускаемый тест не защищает выпуск.
- Найдите секреты и права токенов, ручные команды на сервере, непроверенные миграции, зависимость от одного инженера и отсутствие стабильного предыдущего артефакта.
- Согласуйте релизные окна, требования к доступности, допустимое время восстановления и кто принимает решение о выпуске для критичных систем.
Три обязательных механизма надёжного выпуска
Сборка, безопасность и эксплуатация должны опираться на один и тот же идентификатор версии.
- Происхождение артефакта: коммит, версия зависимостей, результаты обязательных проверок и место хранения доступны без догадок. Это позволяет сравнить продакшен с тем, что команда собиралась выпустить.
- Границы доступа: среда продакшена принимает выпуск только от доверенного процесса с минимальными правами и нужным подтверждением. Переменные и токены не копируются между задачами без причины.
- Восстановление: команда знает, как вернуть предыдущий код, что делать с несовместимой миграцией и какие данные требуется сверить после отката.
- Наблюдение: ошибки, задержка и ключевые бизнес-операции измеряются до и после переключения. Порог остановки и ответственный указаны заранее.
Пошаговое внедрение CI/CD
Первым результатом должна быть неизменяемая проверенная сборка, проходящая контролируемый путь к пользователю.
- Включите единые правила веток и обязательные проверки на изменение: форматирование, статический анализ, типы, быстрые тесты и проверку зависимостей с осмысленной политикой ошибок.
- Собирайте один версионированный артефакт для нескольких окружений. Не пересобирайте код отдельно перед каждым развертыванием, иначе тестировалось не то, что запущено.
- Разведите секреты по окружениям, ограничьте права исполнителя и не выводите значения в логи. Настройки среды проверяйте без публикации секретов.
- Добавьте интеграционные или контрактные тесты там, где отказ дорог: платежи, авторизация, запись данных и внешние API. Синтетическая проверка должна иметь ясный ожидаемый результат.
- Разработайте безопасный порядок миграции базы: совместимая схема, выпуск кода, перенос данных и удаление старого поля отдельными шагами. Откат кода не всегда откатывает данные.
- Постройте пробный релиз в staging на том же артефакте. Проверьте HTTP, ключевой пользовательский сценарий, очередь фоновых задач и лог ошибок.
- Переключайте продакшен ограниченно или атомарно. Храните предыдущий исправный выпуск, проверяйте состояние сервиса после переключения и выполняйте документированный откат при нарушении порогов.
- Назначьте владельца метрик после релиза; автоматизация не заканчивается зелёным статусом конвейера, если приложение у пользователя сломано.
Как понять, что процесс стал лучше
Сравнивайте сопоставимые периоды и не превращайте один показатель в самоцель.
- Время от принятого изменения до доступности пользователю показывает задержку процесса, но не качество выпуска.
- Частота релизов полезна вместе с долей выпусков, потребовавших исправления или отката, и временем восстановления после сбоя.
- Следите за долей нестабильных тестов, длительностью обязательных проверок, числом ручных исключений и необъяснимых различий сред.
- Отдельно измеряйте результат ключевых пользовательских операций после выпуска: безопасный технический деплой может оказаться плохим продуктовым изменением.
Минимально жизнеспособный процесс релиза
Для первого приложения достаточно понятного обязательного набора проверок, единого артефакта, ограниченных прав, staging, проверки после переключения и возвращаемого предыдущего выпуска. Каждый шаг должен быть описан так, чтобы его выполнил не только автор скрипта.
Расширяйте CI/CD на остальные сервисы после одного успешного цикла с учебным откатом. Проверенный путь восстановления ценнее ещё одной зелёной иконки в интерфейсе платформы.
Дорожная карта внедрения по неделям
- Неделя 1 — техлид и инженер эксплуатации: снимок текущего релиза, инвентаризация секретов и миграций, исходные метрики сбоев. Результат — карта рисков и выбранное пилотное приложение.
- Неделя 2 — разработчики: обязательные проверки pull request и воспроизводимая сборка одного артефакта. Результат — плохой пример изменения блокируется до слияния.
- Неделя 3 — инженер эксплуатации и тестировщик: staging, проверка критического сценария, права окружений и эксперимент с несовместимой зависимостью. Результат — сборка развертывается без ручной сборки на сервере.
- Неделя 4 — техлид и дежурный: атомарное переключение, проверка мониторинга и учебный откат. Результат — запись версии, времени восстановления и открытых ограничений перед расширением на другие сервисы.
Пример проверяемого релиза: от коммита до отката
- Допустим, интернет-магазин меняет расчёт стоимости доставки. Pull request должен содержать описание поведения, пример заказа с ожидаемой стоимостью и случай ошибки API перевозчика. Быстрая проверка должна ловить синтаксические и типовые ошибки, но именно контрактный тест объясняет, что партнёрская интеграция не изменила смысл ответа. Если тест зависит от нестабильной внешней сети, используйте контролируемый контракт и отдельно проверяйте интеграцию в подходящем окружении.
- После слияния собирается один артефакт с известным идентификатором коммита. Его проверяют на тестовом окружении с отдельными секретами. Правило простое: если тестировщик видит один образ, а продакшен собирает код заново с другими версиями пакетов, результат тестирования нельзя переносить на выпуск. Для критичной операции добавьте проверку реального пользовательского пути, а не только успешного запуска процесса.
- Перед переключением инженер сравнивает схему базы с предыдущей версией. Если новая версия пишет поле, которого старый код не понимает, обычный откат бинарного файла недостаточен. Разделите изменение на совместимые этапы: добавить новое поле, поддержать старый формат, перейти на новое чтение и лишь позже убрать старое. Этот порядок зависит от системы, но принцип совместимости нужен в плане релиза.
- Продакшен принимает только утверждённый артефакт. Механизм переключения хранит адрес предыдущего исправного выпуска, время операции и человека, отвечающего за решение. Если требуется ручное подтверждение, оно должно быть содержательным: проверить статус тестов, миграций, окно выпуска и готовность дежурного, а не машинально нажать кнопку.
- После переключения выполните несколько наблюдаемых проверок: открытие каталога, расчёт доставки на контрольном заказе, создание заказа в безопасном тестовом режиме, запись ошибки, доступность фоновой обработки. Порог сбоя определяют до выпуска: рост отказов или неверная сумма доставки должны остановить распространение изменения. Логи только процесса сборки не расскажут о проблеме покупателя.
- Учебный откат проводят до первого срочного инцидента. Верните предыдущий артефакт в тестовом окружении, проверьте совместимость с изменённой базой и договоритесь, кто связывается с поддержкой. Если откат оставляет часть заказов в новом состоянии, нужен план сверки, а не заявление «мы можем вернуть код». Запишите фактическое время восстановления и неожиданности.
- Раз в несколько релизов пересматривайте конвейер. Долгая очередь тестов может толкать людей к обходу правил; слабый набор тестов даст ложное спокойствие. Разделите проверки по назначению, удаляйте дубли без потери риска и оставляйте явный след каждого исключения. Главный результат — команда выпускает изменение предсказуемо и умеет восстановить услугу.
Источники
- Understanding GitHub Actions
GitHub Docs / доступ 2026-10-03
Официальное объяснение задач, рабочих процессов и CI/CD.
- Managing environments for deployment
GitHub Docs / доступ 2026-10-03
Официальная документация ограничений и подтверждений для окружений.
- Secrets Management Cheat Sheet
OWASP Foundation / доступ 2026-10-03
Практика управления секретами в жизненном цикле приложения.
FAQ
Обязательно ли сразу включать автоматический деплой?
Нет. Автоматические сборка и проверки полезны и при ручном подтверждении выпуска. Автодеплой включают после проверки секретов, миграций, мониторинга и отката.
Чем отличается continuous delivery от deployment?
Delivery готовит проверенное изменение к выпуску в любой момент; deployment автоматически отправляет его в продакшен после прохождения заданных условий.
Можно ли откатить миграцию базы вместе с кодом?
Не всегда. Безопаснее проектировать совместимые изменения схемы и отдельно описывать восстановление данных, чем предполагать, что старый код исправит структуру базы.
Нужно ли гонять все тесты на каждый коммит?
Быстрые блокирующие проверки нужны рано; тяжёлые тесты можно запускать на другом этапе. Важно, чтобы релиз не обходил проверки, нужные для его рисков.